Overview
プロジェクト概要
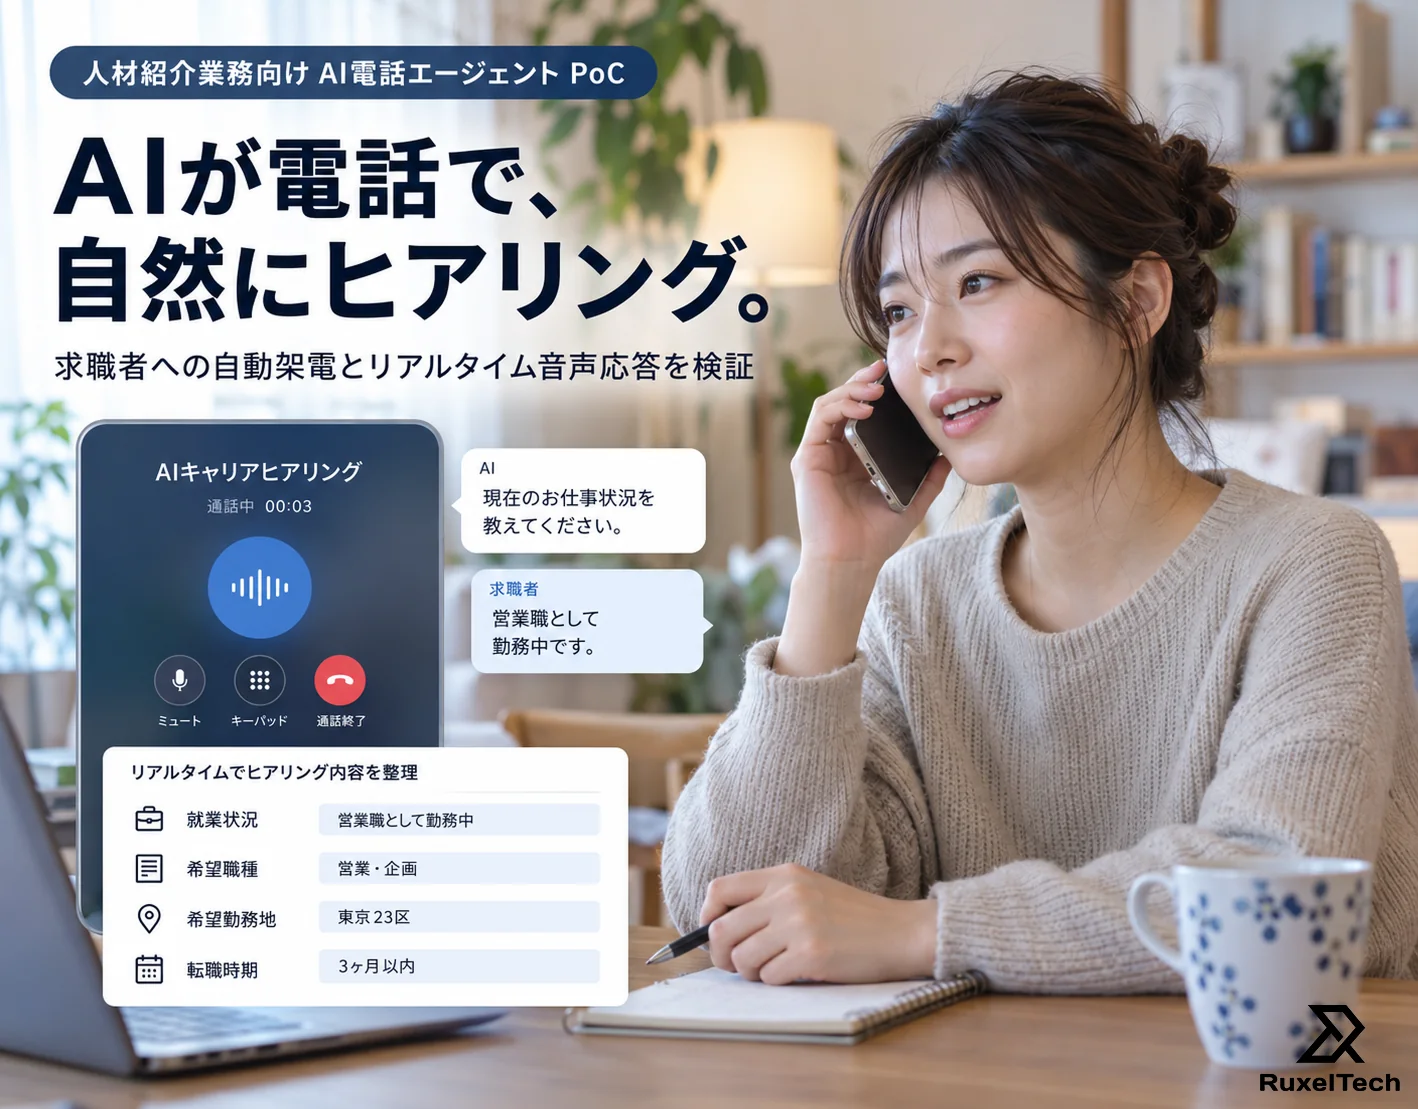
人材紹介業務での、求職者への自動架電とAIによるヒアリングを想定したPoC(概念実証)です。電話の音声をリアルタイムに受け取り、音声認識(STT)、Claude、音声合成(TTS)を経由して、電話へ音声を返す仕組みを構築しました。想定した業務は、求職者へ自動で電話をかけ、就業状況、希望条件、転職の時期などを会話の形で聞き取るものです。
このPoCの成果物は、「AIが喋るデモ」ではありません。STT・LLM・TTSの各処理を計測でき、かつ入れ替えられる状態にした音声パイプラインです。AIの最初の音声が返るまでの時間を1.5秒以内とする目標を置き、4週間で、電話の疎通から会話、低遅延化、評価までを段階的に進めました。
※ 掲載している画面とデータは、説明用に再構成したイメージです。
- 分類
- AI音声(電話でのAI自動応答)の概念実証(PoC)
- 想定業務
- 人材紹介会社から求職者への自動架電と、AIによるヒアリング
- 主な目標
- AIの最初の音声が返るまでの時間を1.5秒以内として検証
- 進め方
- 4週間(電話の基盤 → AIパイプライン → 会話体験 → 評価)
- 成果物
- 実電話でのPoC / 音声パイプライン / 応答遅延の計測 / STT・TTSの比較評価 / 本開発の構成案
- 業種
- 人材紹介
- ロール
- 電話の基盤 / 音声のストリーミング処理 / 音声認識・AI応答・音声合成の組み込み / 応答遅延の計測 / 評価設計 / 本開発の構成提案
- 技術
- Twilio / Node.js / TypeScript / WebSocket / Claude API / Deepgram / ElevenLabs / Google STT / TTS
01 — 検証した課題
AI電話は、「話せる」だけでは使えない
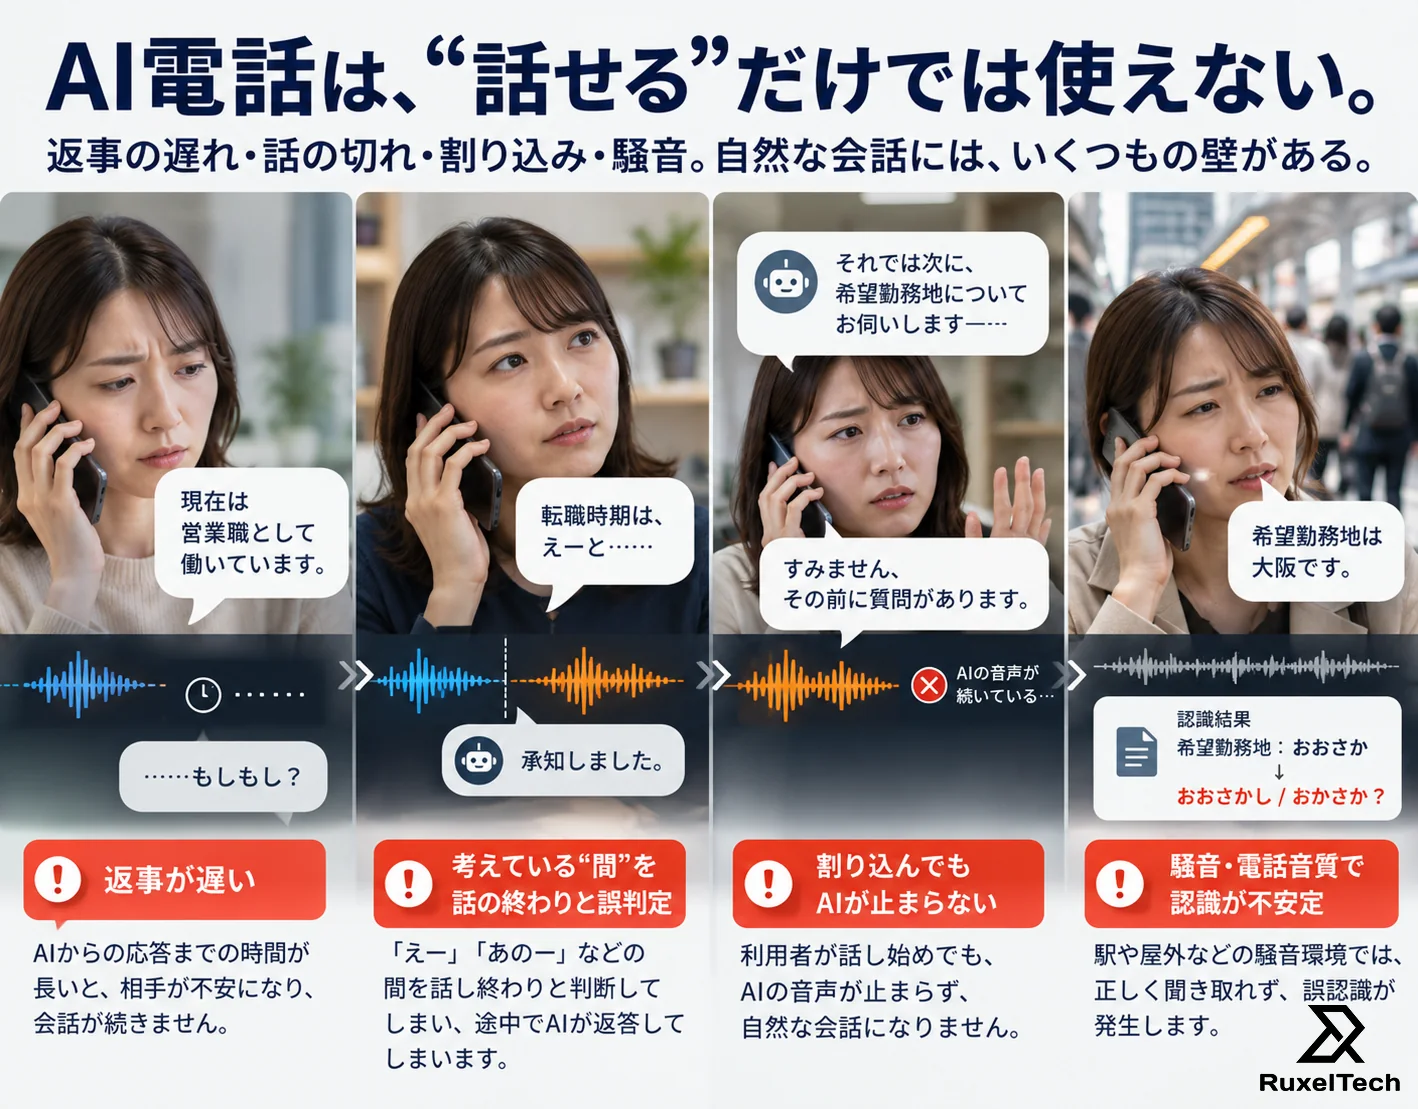
電話でのAI応答が会話として成り立つかどうかは、4つの点に左右されます。AIからの返事が遅いと、相手は不安になって「もしもし?」と聞き返します。「えー」「あのー」といった考えている間を話の終わりと誤って判定すると、途中でAIが返事をしてしまいます。利用者が割り込んでもAIの音声が止まらなければ、自然な会話になりません。さらに、駅や屋外の騒音と電話特有の音質のもとでは、認識が不安定になります。このPoCでは、この4つを実際の電話で確かめました。
- 返事が遅いと、相手が不安になり会話が続かない
- 考えている「間」を、話の終わりと誤判定する
- 割り込んでも、AIの音声が止まらない
- 騒音と電話の音質で、認識が不安定になる
02 — 音声パイプライン
話した瞬間から、返事をつくり始める
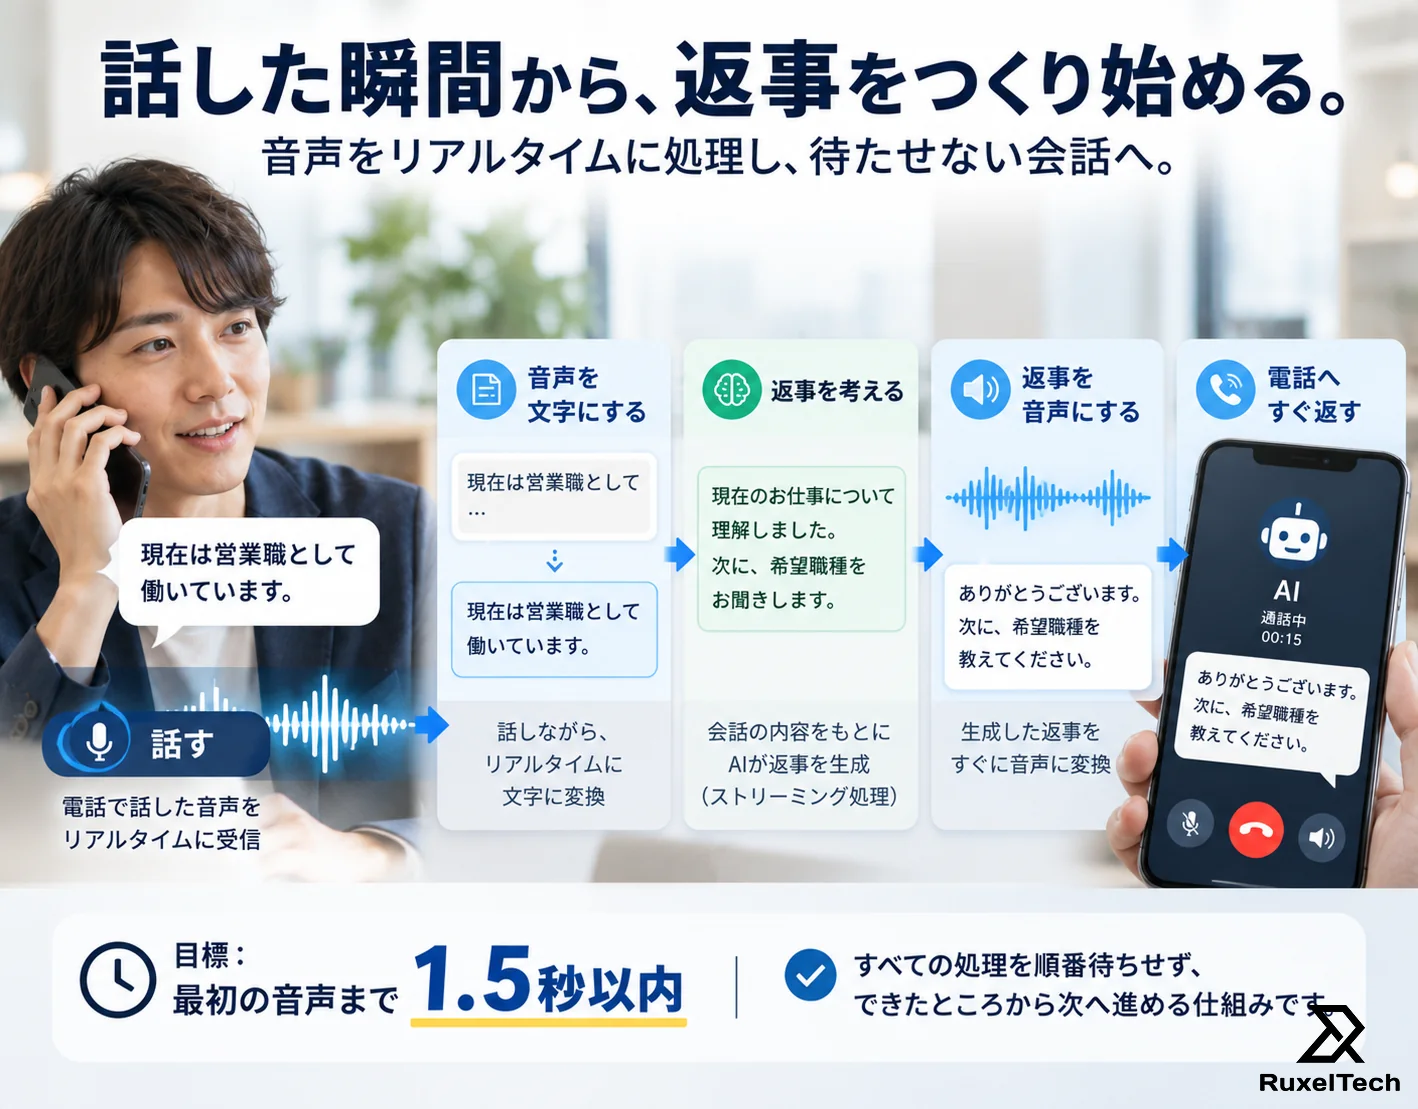
利用者の音声は、Twilioから細かい単位でリアルタイムに届きます。話している途中から音声認識で文字にし、発話の区切りを受けてClaudeへ渡します。Claudeの応答は、全文の完成を待たずに短い文の単位に分けて音声合成へ渡し、できた順に電話へ返します。「全文を生成してから全文を音声にする」という順番待ちをなくすことで、最初の音声が返るまでの時間を短くしました。音声の形式は電話網の仕様(μ-law・8kHz)に合わせ、不要な変換を減らしています。
- 電話の音声をリアルタイムに受信(Twilio Media Streams)
- 話している途中から、音声認識で文字に変換
- Claudeの応答を短い文に分けて、順に音声合成へ
- 目標:最初の音声まで1.5秒以内
開発中の課題と解決
処理を順番に待つと、遅延が積み上がる
- 課題
- 音声認識 → AIの応答 → 音声合成を順番に待つと、それぞれの待ち時間が積み上がり、相手が「反応がない」と感じます。
- 解決
- すべてをストリーミング処理にし、最初の音声を早く返すことを優先しました。1回の応答について、発話終了の候補から電話への音声の返却まで、処理の各時点の時刻を記録して計測できるようにしています。評価は平均値だけでなく、中央値(P50)・95パーセンタイル(P95)・最大値で見ます。
03 — 実電話での検証
速いだけでは、自然な会話にならない
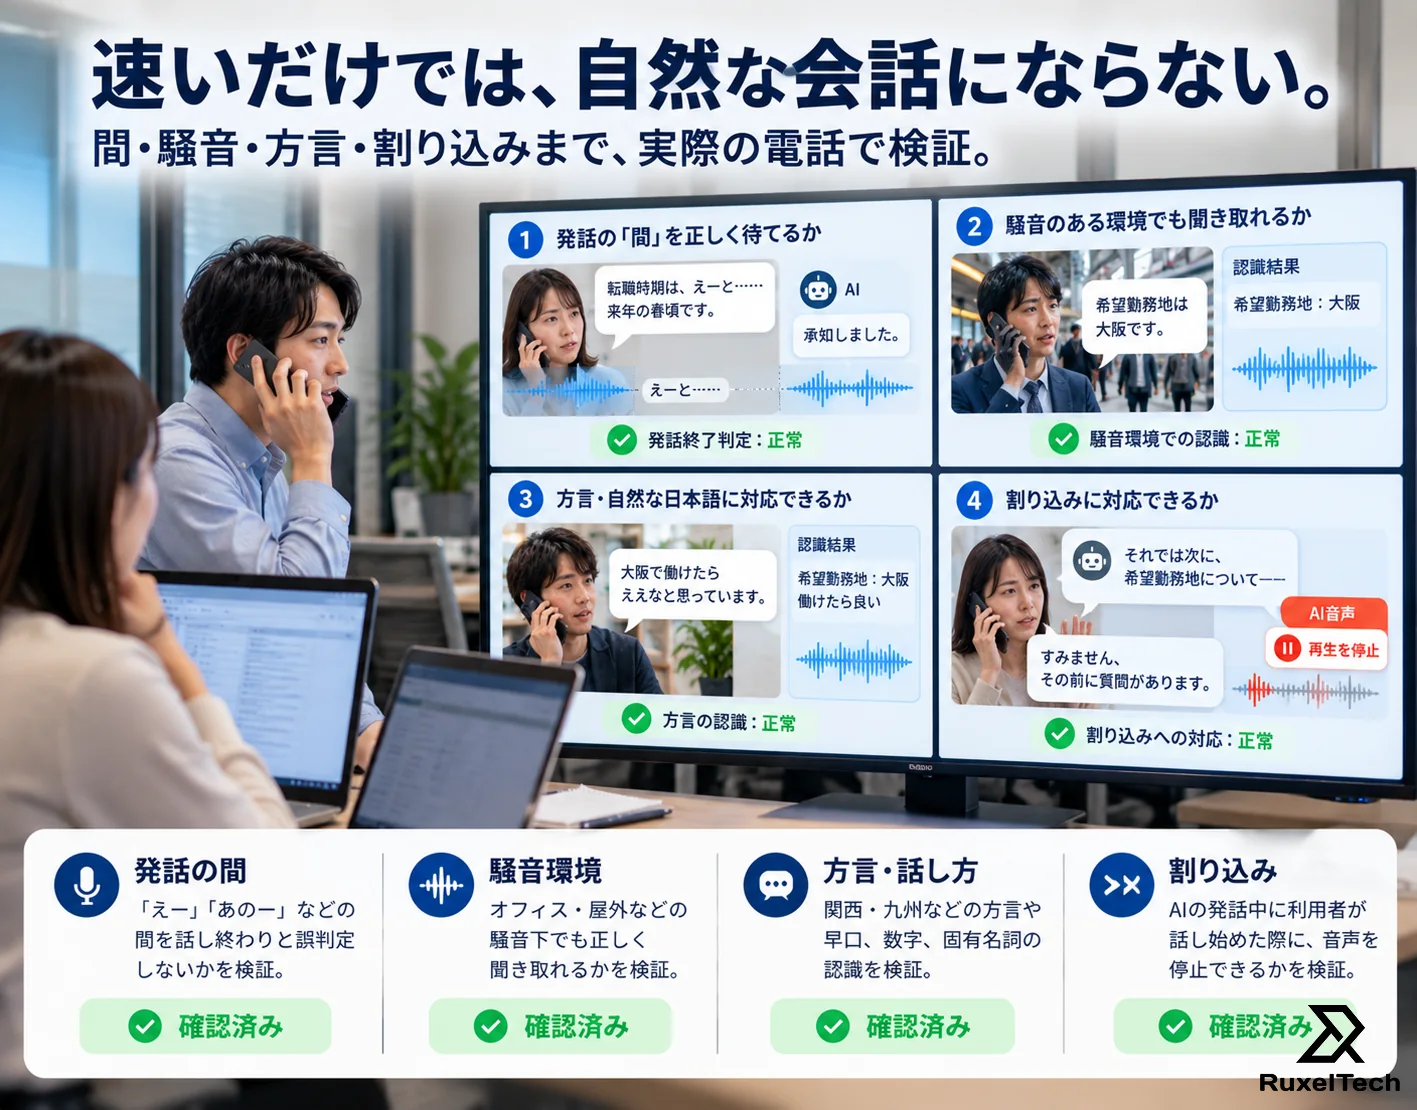
検証は、実際の電話の音声で行いました。静かな環境の短文・長文から、オフィスや屋外の騒音、早口、「えー」などが多い自然な会話、関西・九州などの方言、電話番号や年月日といった数字、固有名詞、AIの発話中の割り込みまで、10種類の条件を用意しています。AIが話している途中に利用者が話し始めた場合は、割り込みを検知して再生中の音声を止めます。
- 発話の「間」を、話し終わりと誤判定しないか
- オフィス・屋外などの騒音下で聞き取れるか
- 方言・早口・数字・固有名詞を認識できるか
- 割り込まれたときに、AIの音声を止められるか
開発中の課題と解決
発話終了の判定は、「速ければ良い」ではない
- 課題
- 日本語は「えー」「あのー」や途中の間が多く、短い無音で発話が切れてしまいます。判定を短くすると応答の開始は速くなりますが、利用者が考えている間を、発話の終わりと誤って判定するおそれがあります。
- 解決
- 途中の確定と発話の区切りを同じものとして扱わず、最終的な発話の単位を組み立ててからClaudeへ渡すようにしました。判定の長さは300・400・500ミリ秒などの条件で会話テストを行い、速さと自然な会話のどちらを取るかを、実際の音声で評価する設計にしています。
04 — 評価と本開発への判断材料
「動いた」で終わらせず、本開発の判断材料にする
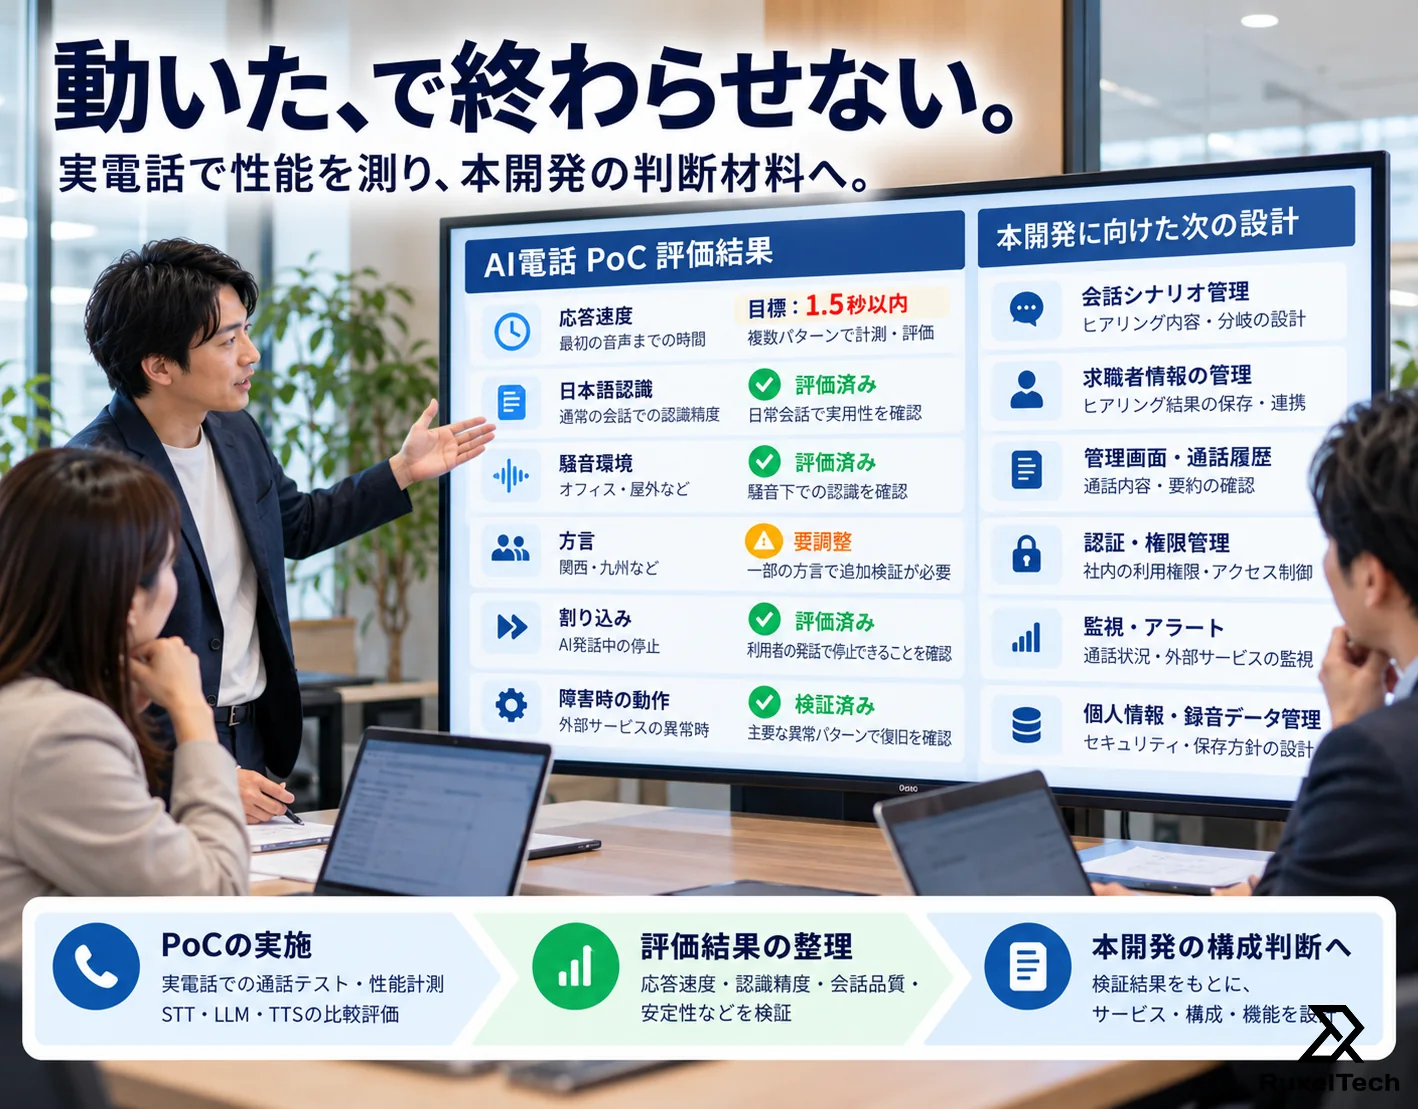
PoCの結果は、本開発へ進めるかどうかを判断する材料として整理しました。最初の音声までの遅延、日本語の認識、騒音への強さ、方言、割り込み、障害からの復旧の6項目に判定の基準を置いています。あわせて、会話シナリオの管理、求職者情報のデータベース設計、管理画面と通話履歴、認証と権限、監視とアラート、個人情報と録音データの保存・削除の方針など、次の段階で加える項目をまとめました。
- 6つの評価項目に、進めるかどうかの判定基準を設定
- STT・TTSを、同じ条件・同じテスト音源で比較
- 主要なAPIの障害時の動作と記録を設計
- 次の段階で加える項目を整理し、本開発の構成案を提示
開発中の課題と解決
PoCの段階でサービスを固定すると、比べられない
- 課題
- 音声認識や音声合成のサービスを最初から1つに決めてしまうと、精度・遅延・費用を比べられません。
- 解決
- STTとTTSを共通の接続口(Adapter)の後ろに置き、Voice Gatewayや会話の制御を変えずに差し替えられる構造にしました。ストリーミング対応、最初の応答までの遅延、日本語、騒音、方言、電話音声(8kHz)への適合、費用、運用のしやすさを軸に、同じテスト音源で比較できます。
Scope
担当範囲
電話の発着信から、音声のリアルタイム処理、遅延の計測、評価の設計、本開発の構成の提案までを対象に、当社がPoCを構築しました。
| 工程 | 担当 |
|---|---|
| 電話の基盤 | 自動発信・着信、SMS送信、通話録音 |
| 音声のストリーミング処理 | Twilio Media Streamsによる音声の受け渡し、WebSocketでの接続 |
| 音声認識(STT) | Streaming STTの組み込み |
| AI応答(LLM) | Claude APIによる応答の生成と会話の制御 |
| 音声合成(TTS) | Streaming TTSの組み込みと、電話への音声の返却 |
| 計測 | 応答遅延の計測 |
| 評価 | 日本語・騒音・方言の簡易評価、STT・TTSの比較評価 |
| 提案 | 本開発の構成案 |
Architecture
使用技術・システム構成
- 電話網との境界
- Twilio(Voice / SMS / Recording / Media Streams)。PSTN/VoIPの発信・着信
- Voice Gateway
- Node.js / TypeScript。WebSocketで音声を受け渡し、通話ごとに状態を管理
- 音声認識(STT)
- Deepgram / Google のストリーミング認識を、同じパイプラインで比較できる構成
- AI応答(LLM)
- Claude API(ストリーミング応答) / 会話の制御
- 音声合成(TTS)
- ElevenLabs / Google のストリーミング合成を、同じパイプラインで比較できる構成
- 音声の形式
- Twilio Media Streamsの仕様に合わせた μ-law・8kHz・モノラル
主な技術の選定理由
Twilioを電話網との境界に置く
Voice・SMS・Recording・Media Streamsを一か所に集めるためです。
Voice Gatewayで通話ごとの状態を管理
STT・LLM・TTSを互いに依存させず、切り離して扱えるようにするためです。
STT・TTSを共通の接続口(Adapter)の後ろに置く
サービスを比較しても、Voice Gatewayや会話の制御を変えずに差し替えられるようにするためです。
音声の形式をTwilioの仕様に合わせる
不要な変換の処理をできるだけなくし、遅延を増やさないためです。
Process
開発の進め方
- 1
1週目(電話の基盤):Twilioの番号、発信、SMS、録音、Media Streams、WebSocketの疎通。電話の音声をGatewayまで受信できることを確認しました。
- 2
2週目(AIパイプライン):Streaming STT、Claude、Streaming TTS、音声の返却。実電話でAIが返答するところまで進めました。
- 3
3週目(リアルタイムの会話体験):発話終了の判定、応答の分割、遅延の計測、割り込み。会話として成り立つことを確かめました。
- 4
4週目(PoCの評価):騒音、方言、STT・TTSの比較、負荷・障害の確認を行い、進めるかどうかの判定と本開発の構成案をまとめました。
- 5
すべて作ってから問題が見つかると、原因の切り分けが難しくなります。そのため、最初に電話の音声だけを通し、次にSTT、次にAIの応答、最後に低遅延化という順で、危険の大きいところから段階的につなぎました。
Quality & Security
品質・セキュリティ・運用
応答遅延の計測
1.5秒以内という目標を、測れる指標に分けました。発話終了の候補、STTの確定、Claudeへの要求、Claudeの最初の出力、TTSの最初の音声、Twilioへの送信の各時点の時刻を記録します。P95が1.5秒を超える場合は、平均値だけで達成と判断せず、遅延が起きた条件を切り分けます。
日本語音声の評価
静かな環境の短文・長文、オフィスの騒音、屋外の高い騒音、早口、「えー」などが多い会話、方言、数字、固有名詞、割り込みの10種類の条件で評価する設計にしました。
障害への備え
STTの切断、Claudeの応答の時間切れ、TTSの失敗、Twilioの切断のそれぞれについて、再接続・代わりの応答・後片付けなどの動作と、記録する内容を決めました。PoCでも「正常な場合だけ動く」状態を完成とはしない方針です。
セキュリティ
偽の通知(Webhook)はTwilioの署名の検証で防ぎます。APIキーはSecret Managerと環境変数で管理し、アクセスを記録します。
個人情報
人材紹介の用途では、氏名、電話番号、職歴、希望条件、通話の録音などを扱う可能性があります。録音の告知、保存期間、ログへの個人情報の出力、外部APIへ送る範囲、削除の手順を、本開発の前に整理する前提としました。
Results
成果
PoCの成果を「動作確認」で終わらせず、性能、音声の品質、運用、セキュリティの評価を、次の段階の設計の判断につなげることを最終成果としました。
- 電話の音声をリアルタイムに受け取り、STT・Claude・TTSを経由して電話へ音声を返す音声パイプラインを構築しました。
- STT・LLM・TTSの各処理を、時刻の記録で計測できる状態にしました。
- STTとTTSを共通の接続口の後ろに置き、会話の制御を変えずに入れ替えて比較できる構造にしました。
- 進めるかどうかの判定の基準と、次の段階で加える項目を整理しました。
FAQ
技術面のよくあるご質問
- Q. なぜSTT・TTSを入れ替えられる構造にしたのですか?
- PoCの段階でサービスを固定すると、精度・遅延・費用を比べられないためです。共通の接続口の後ろに実装を置き、Voice Gatewayや会話の制御を変えずに差し替えられるようにしました。
- Q. 応答の遅れはどう抑えていますか?
- Claudeの全文の完成を待たず、短い文の単位に分けてTTSへ渡します。「全文を生成してから全文を音声にする」という順番待ちを避けています。
- Q. 発話の終わりはどう判定していますか?
- 途中の確定と発話の区切りを同じものとして扱わず、最終的な発話の単位を組み立ててからLLMへ渡します。判定の長さは、速さと自然さの両方を実際の音声で評価します。
- Q. AIが話している途中で話しかけるとどうなりますか?
- 割り込みを検知し、Twilioのclearで再生中の音声を止めます。
- Q. 電話の音声は、普通のマイクと違いますか?
- 電話網では8kHzの音声になり、Webのマイク向けの音声認識とは条件が違います。そのため、電話の音声の条件で評価する設計にしました。
Tech Stack