Overview
プロジェクト概要
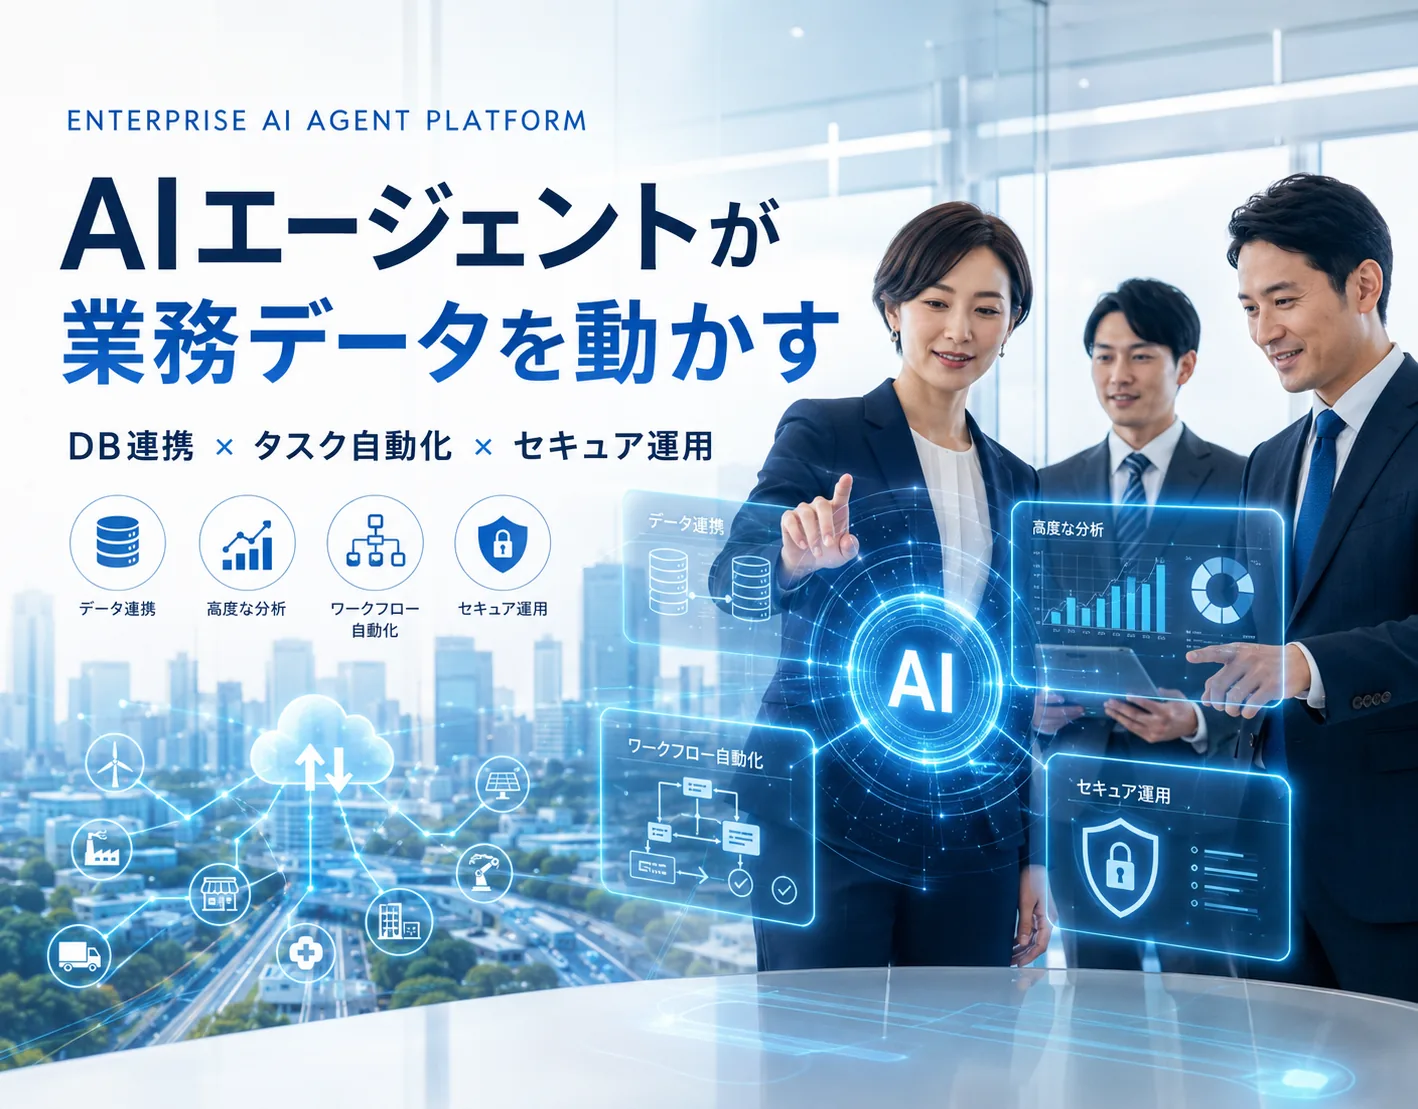
AIを活用して、データベースの分析と業務の自動化を行う企業向けクラウドサービス(B2B SaaS)を、ゼロから開発しました。利用者は普段の言葉で対話するだけでデータベースを操作・分析でき、その一連の作業を「タスク」として登録して、繰り返し自動で実行できます。Gmail・Googleカレンダー・Googleドライブとも連携し、分析結果はHTML・CSV・JSONなどの形式で自動出力します。
開発期間は2025年5月から2026年5月までの約1年間、体制はエンジニア・UI/UXデザイナー・テスターの3名です。最小限の機能で始めた版から本番運用に向けて、機能の追加・統合と基盤の作り直しを重ねながら育てました。当社は、お客様の事業担当者から業務の要件を受け取り、要件整理から設計、実装、AWSでのインフラ構築、リリースまでを担当しています。
※ お客様との守秘義務のため、業界・お客様名・製品名は記載していません。掲載している画面とデータは、説明用に再構成したイメージです。
- 分類
- 企業向けクラウドサービス(B2B SaaS)の新規開発
- 開発期間
- 2025年5月〜2026年5月(約1年間)
- 体制
- 3名(エンジニア1名 / UI/UXデザイナー1名 / テスター1名)
- 利用者
- 企業の業務担当者(エンジニアではない方が中心)
- 業種
- IT・通信・インターネット
- ロール
- 要件整理 / 設計 / データベース設計 / フロントエンド / バックエンド / 外部サービス連携 / AWSインフラ構築 / テスト・リリース
- 技術
- Next.js 15 / React 19 / TypeScript / Python / FastAPI / PostgreSQL / Redis(arq) / MCP / OpenAI / Gemini / Claude / AWS(EC2 / RDS / S3) / MySQL / Oracle Database / SQLite
01 — 導入前の課題
データを見るたびに、エンジニアへの依頼と手作業が発生していた
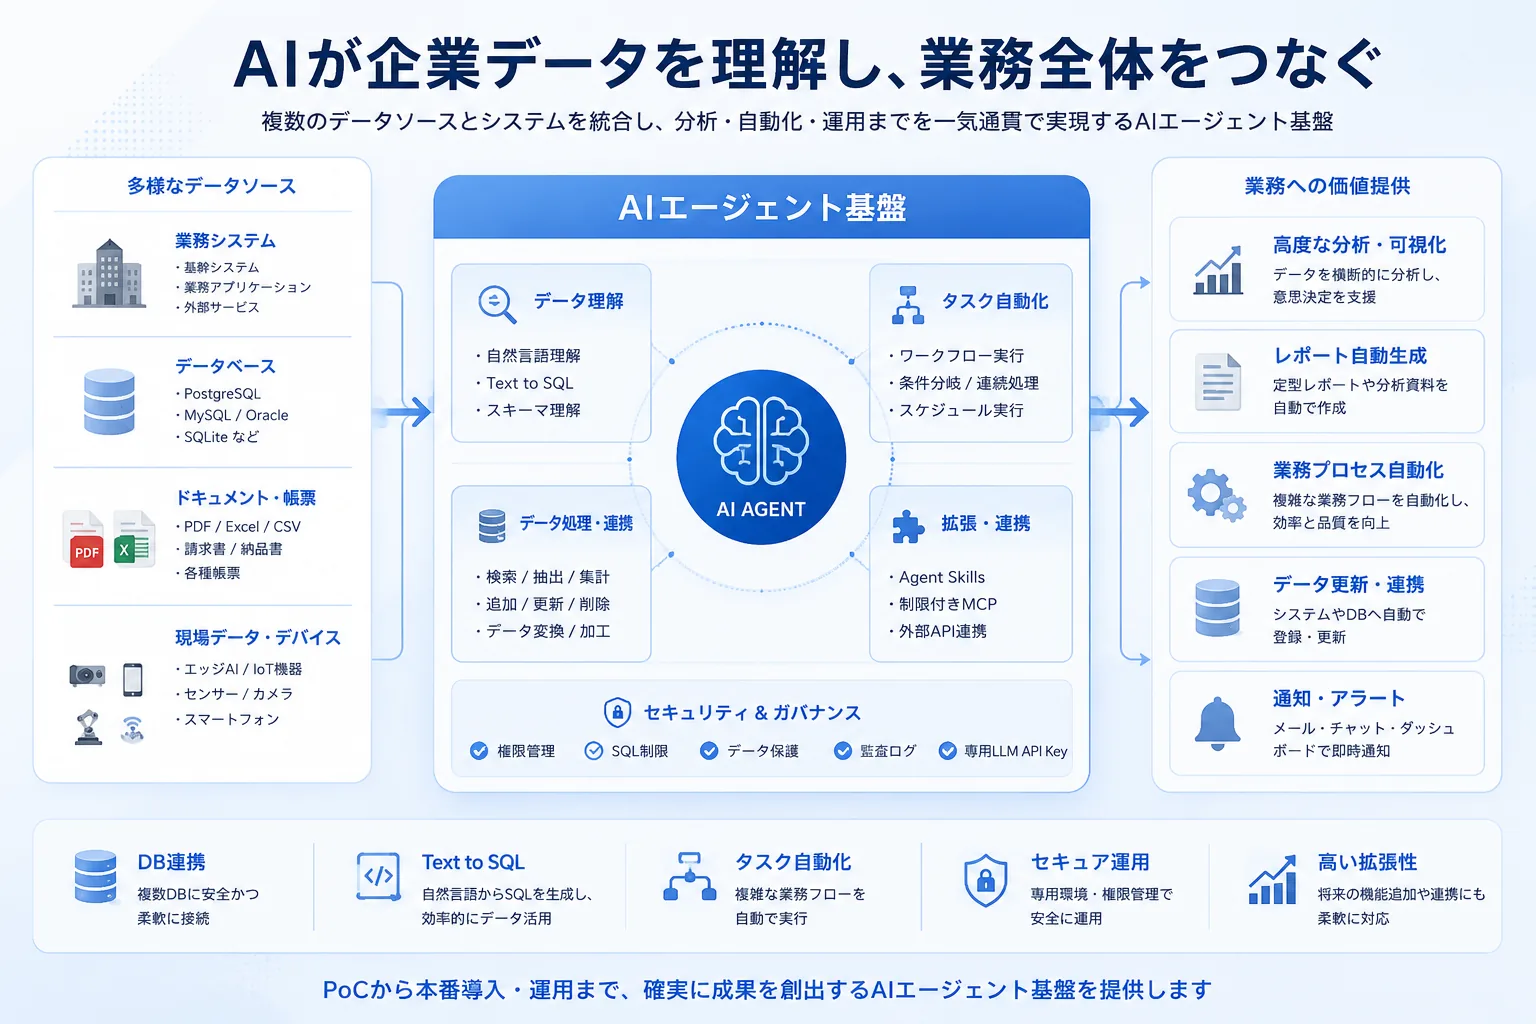
導入前は、社内データベースからデータを取り出すにも、SQLやプログラミングの知識が必要でした。そのためエンジニアではない業務担当者は、データが必要になるたびにエンジニアへ抽出を依頼し、受け取ったデータを手作業で集計・整形していました。さらに「検索 → 加工 → データベースへの書き戻し → メール通知」のような複数の手順からなる定型作業は、手順を知っている特定の人に依存していました。毎週・毎月、同じ作業を最初からやり直しており、同じ手順で確実に繰り返せる状態ではありませんでした。
- データを見るたびに、エンジニアへ抽出を依頼
- 抽出したデータを、手作業で集計・整形
- 毎週・毎月、同じ作業を最初から繰り返す
- 確認・資料作成・共有を、別々のツールで処理
02 — 対話でのデータ分析
「今月の売上を商品別に」と話しかけるだけで、集計結果が返る
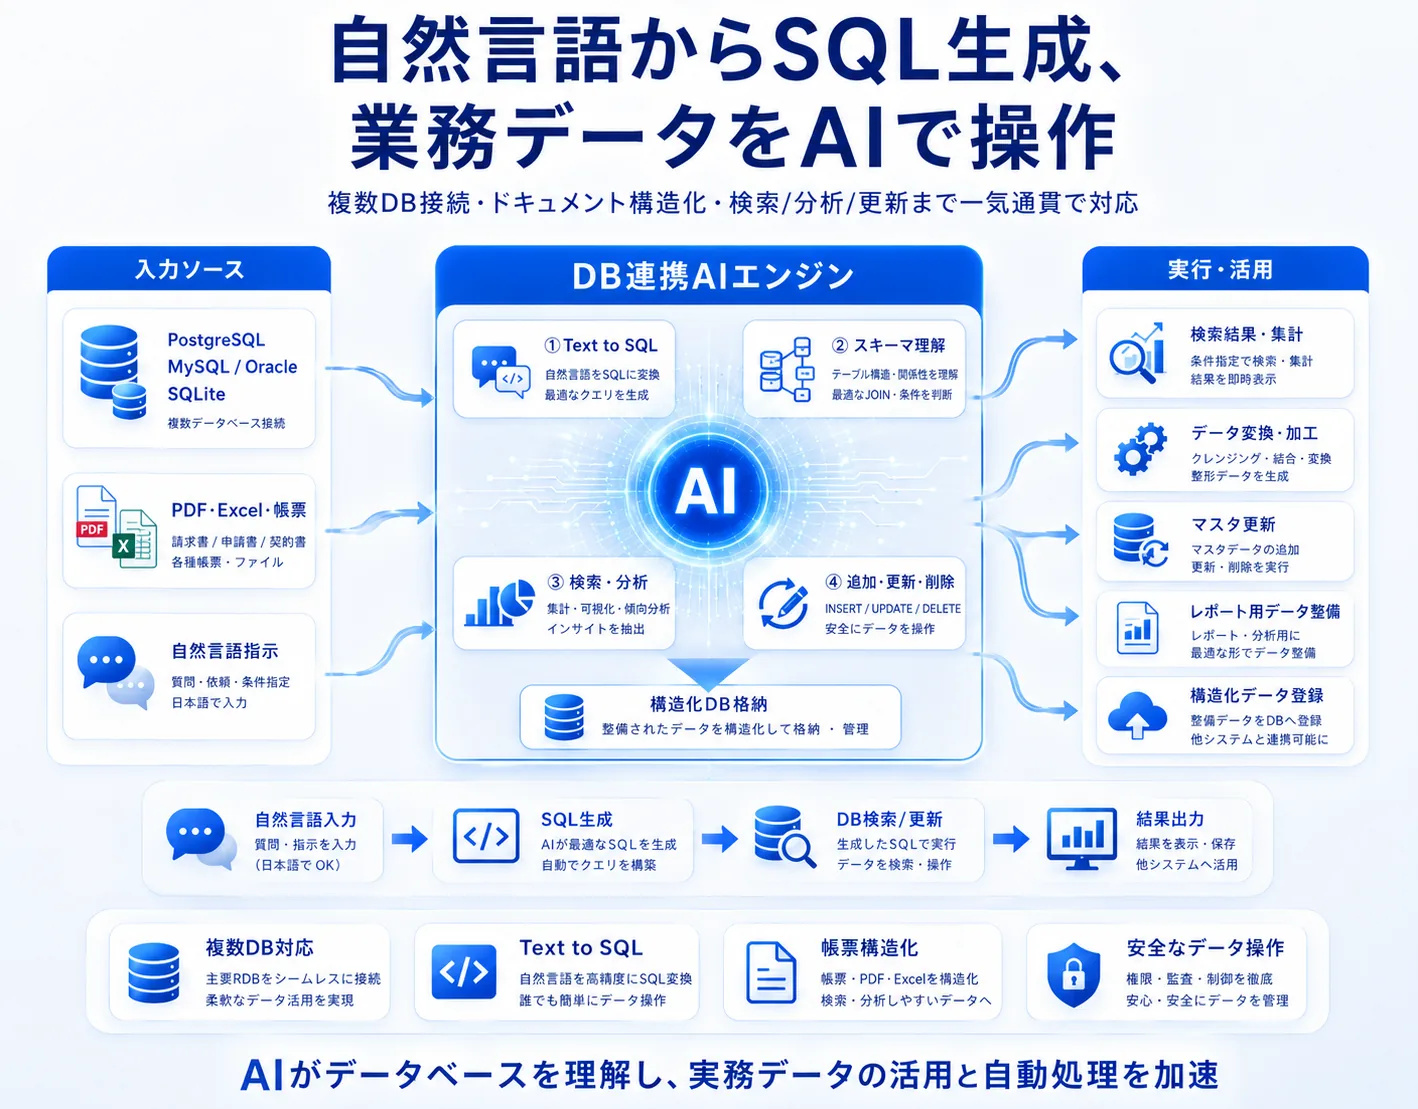
利用者は、チャット欄に普段の言葉で依頼を書くだけです。たとえば「今月の売上を商品別に集計してください」と入力すると、AIが接続先のデータベースに問い合わせ、結果を表とグラフで返します。続けて「前月比も表示してください」と頼めば、直前の結果を踏まえて前月比の列が加わります。結果は、その場でCSVやレポートとして出力できます。接続先は、お客様企業がすでに使っているデータベースです。MySQL・PostgreSQL・Oracle Database・SQLiteの4種類に対応しました。
- SQLを書かずに、普段の言葉で検索・集計・分析
- 会話を続けて、条件の追加や絞り込みができる
- 接続先:MySQL / PostgreSQL / Oracle Database / SQLite
- 出力形式:HTML / CSV / JSON / SVG / PlantUML / Mermaid
- Excel・PDF・Word・PowerPointの読み込み(OCRにも対応)
- AIはOpenAI(Azure OpenAI)・Gemini・Claudeを切り替えて利用
開発中の課題と解決
時間のかかるAI処理で、画面が止まる
- 課題
- AIと外部APIの呼び出しは、数十秒から数分かかることがあります。画面からの要求の中でそのまま処理すると、時間切れになったり、画面が固まったりしていました。
- 解決
- チャットとタスクの処理をジョブキュー(arq+Redis)に回して裏側で実行し、進み具合はSSEでリアルタイムに画面へ送る構成にしました。ジョブの記録を残し、古い記録は毎日自動で整理しています。重い処理でも画面が固まらず、進捗が見え、失敗したときも原因を追跡できます。
03 — 定型業務の自動化
一度登録した手順を、毎回同じ結果で繰り返し実行
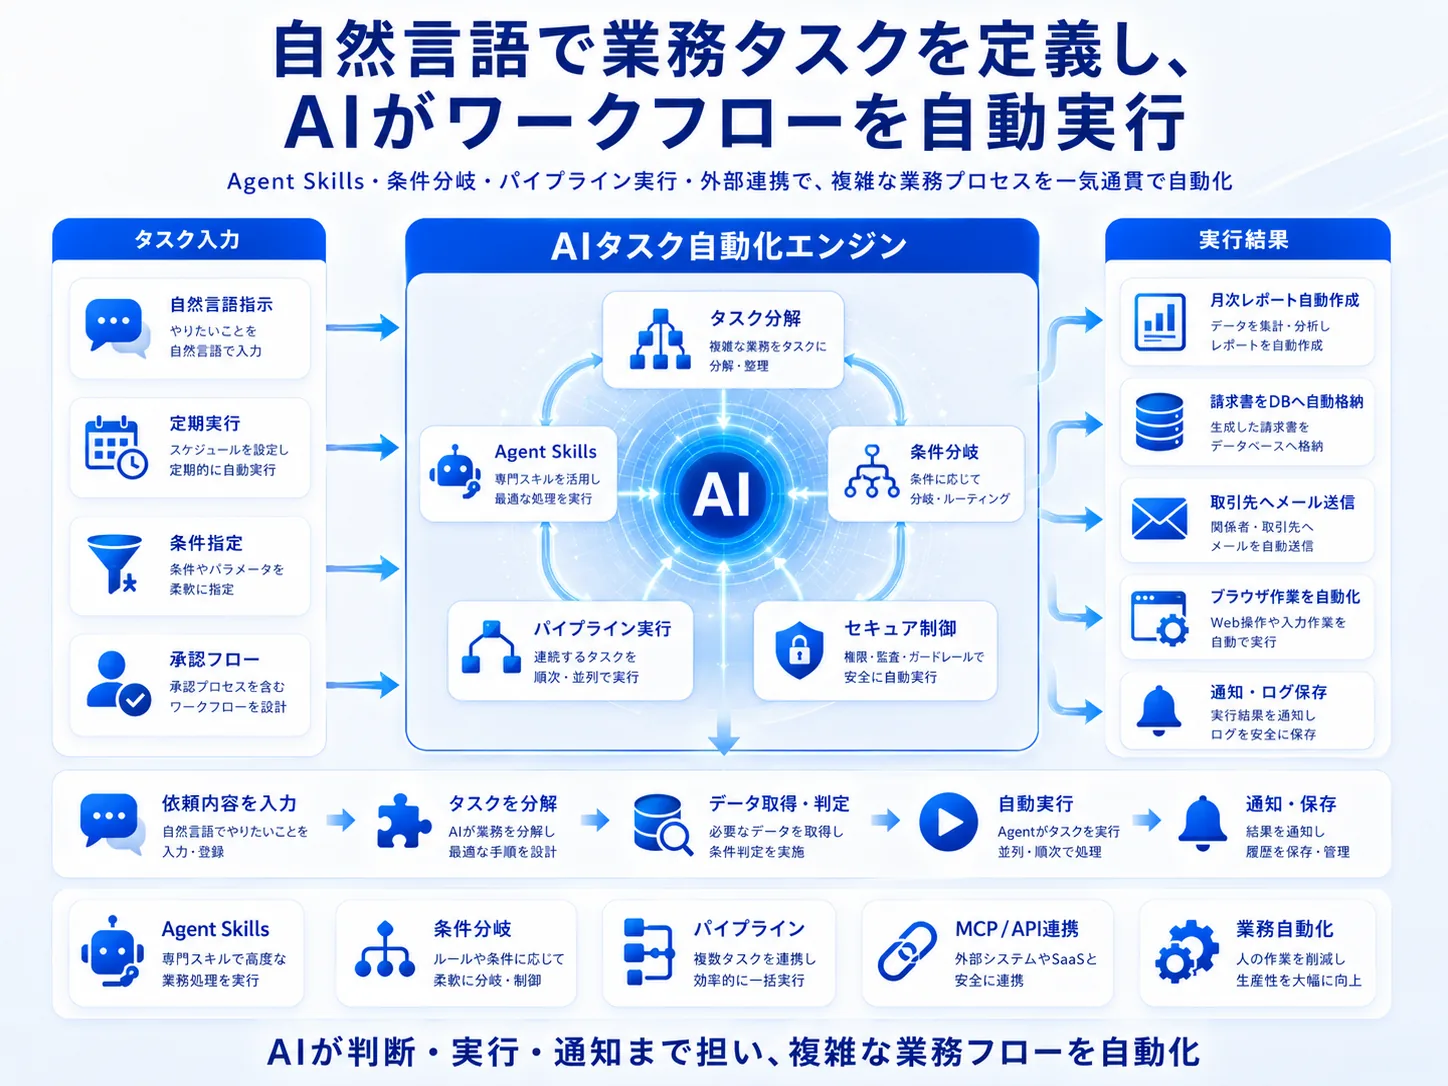
チャットで行った一連の作業は「タスク」として登録でき、複数のタスクを「タスクグループ」にまとめて順に実行できます。画像の例では、「売上データ取得 → 商品別・地域別に集計 → レポート作成 → 営業チームへ通知」の4つの手順を月次売上レポートとして登録し、毎月1日の午前9時に自動で実行しています。実行のたびに履歴が残るので、いつ実行され、どの手順まで完了したかを後から確認できます。
- 一連の手順を「タスク/タスクグループ」として登録
- 登録した手順を、決まったタイミングで自動実行
- 手順ごとの進み具合を、実行中に画面で確認
- 実行履歴を残し、失敗時も処理を追跡できる
開発中の課題と解決
AIに任せた処理の結果が、毎回揺れる
- 課題
- AIに複数の手順をまとめて任せると、同じタスクを繰り返しても毎回結果が変わり、業務で繰り返し使える自動化になりませんでした。どの処理がAIに依存して揺れているかを切り分けたところ、ファイルの取得、条件の判定、繰り返し処理の展開をAIに任せていたことが原因でした。
- 解決
- これらの処理を、AIではなく、毎回同じ結果を返すプログラム側に移しました。繰り返し処理は共通の仕組みにまとめ、同じ入力から同じ手順を再実行できる設計に作り替えています。条件の判定は、テストで動きを固定しました。同じタスクを再実行しても結果が安定し、信頼して繰り返し使える自動化になりました。
04 — 確認・反映・共有
人が確認してから反映し、必要な人へ届けるまでを一つの流れに
AIの出力を、そのままデータベースへ反映することはありません。書き戻しの前に必ず「データ確認」の工程を挟み、担当者が変更前と変更後を見比べ、必要なら修正してから確定します。画像の例では、更新対象24件の変更内容を項目ごとに確認し、「確認して反映」を押して初めてデータベースが更新されます。確定後は、レポートをGoogleドライブへ保存し、Gmailで関係者へ送信し、次回の予定をGoogleカレンダーに登録するところまで、サービスの中で完結します。
- 反映前に、人が変更前・変更後を確認して修正できる
- 接続先のデータベースごとに、読み書きの権限を制御
- 書き込む前に、データの列と型を検証
- MCPでGmail・Googleカレンダー・Googleドライブ・ローカルファイルに接続
- Google連携は、OAuthで安全に認可を受ける
- 分析から共有までを、一つのサービスの中で完結
開発中の課題と解決
利用者のデータベースへ、安全に書き戻す
- 課題
- 検索結果を利用者のデータベース(MySQL・PostgreSQL・Oracle・SQLite)へ書き戻すとき、親子関係(1対多)のあるデータや、データベース側で自動で番号を振る主キーを含むと、不整合やエラーが起きていました。
- 解決
- 書き込む前に自動採番の列を取り除き、親から子の順に書き込むようにしました。あわせて、書き込むデータの列と型を事前に検証しています。これにより、利用者のデータベースへの書き戻しを、整合性を保ったまま安全に行えるようになりました。
Scope
担当範囲
ゼロからの新規開発です。お客様の事業担当者から業務の要件を受け取り、要件・設計・実装に落とし込みました。
| 工程 | 担当 |
|---|---|
| お客様へのヒアリング・要件整理 | 当社(事業側の要件を整理し、仕様化) |
| 基本設計・詳細設計・全体構成の設計 | 当社 |
| データベース設計 | 当社 |
| フロントエンド開発 | 当社 |
| バックエンド開発 | 当社 |
| 外部API・MCP連携 | 当社 |
| 非同期・バックグラウンド処理の基盤 | 当社 |
| インフラ構築(AWS) | 当社 |
| テスト対応・リリース | 当社 |
| UI・画面デザイン | デザイナー(当社が実装側から仕様を調整) |
| コードレビュー | テスター |
実装だけでなく、技術の選定、全体構成の決定、作業範囲と優先順位の判断まで担いました。たとえば、開発の途中で別々に増えていった複数の対話モードを、共通の「ワークスペース基盤」の上にまとめる設計に切り替えています。影響する範囲を整理したうえで、既存の機能を壊さないよう段階的に移行しました。
Architecture
使用技術・システム構成
- フロントエンド
- Next.js 15(App Router) / React 19 / TypeScript / Tailwind CSS 4 / TanStack React Query / Axios / Radix UI / Framer Motion
- バックエンド
- Python / FastAPI / SQLAlchemy / Pydantic / Alembic
- サービス自身のデータベース
- PostgreSQL(開発・本番とも統一。本番はAWS RDS)
- 接続先(利用者側)のデータベース
- MySQL / PostgreSQL / Oracle Database / SQLite
- AI・LLM
- OpenAI(Azure OpenAI) / Google Gemini / Anthropic Claude を切り替えて使える構成
- 外部サービス連携
- MCP(Model Context Protocol)でGmail・Googleカレンダー・Googleドライブ・ローカルファイルに接続 / Google OAuth認証
- 非同期処理
- arq+Redis(ジョブキュー) / SSE(進捗のリアルタイム配信) / cron(日次の整理処理)
- ファイル処理
- pandas / openpyxl(Excel) / pdfplumber(PDF) / python-docx・python-pptx(Word・PowerPoint) / EasyOCR・PyTesseract(OCR) / weasyprint・reportlab(PDF生成)
- 認証・セキュリティ
- JWT / bcrypt / RBAC(役割とデータベースごとの読み書き権限) / slowapi(アクセス回数の制限)
- インフラ
- AWS EC2(アプリ) / RDS(PostgreSQL) / S3(ファイル保管)
主な技術の選定理由
FastAPI
AIや外部APIの応答待ちが多いため、待ち時間の間に他の処理を並行して進められる非同期の仕組みが効きます。Pydanticと組み合わせて、データの形を厳密に検証できます。
開発・本番ともPostgreSQL
「開発では動くのに本番で壊れる」という、環境の違いから起きる不具合を防ぐためです。同時実行や整合性、バックアップなどの運用面にも強みがあります。
arq+Redis
AIの処理は数十秒から数分かかることがあるため、画面からの要求の中で完結させず、裏側の処理に回しました。進捗はSSEで画面に送り、待ち時間の体感を損なわないようにしています。
MCP
外部サービスとの接続を一つずつ個別に作るのではなく、AIの道具をつなぐ標準規格でそろえました。後から連携先を増やしやすくなります。
AIの提供元を切り替えられる構成
特定の提供元に縛られることを避け、費用と精度に合わせて調整できる余地を残しました。
Process
開発の進め方
- 1
お客様のGitHubリポジトリに招待いただき、その上で開発しました。
- 2
機能ごとにブランチを作り、実装後はテスターのコードレビューを経て、承認されてから統合しました。
- 3
変更の記録は「機能追加」「修正」の単位で分け、変更の意図を後から追えるようにしました。
- 4
大きな仕様変更が出たときは、すぐに実装せず、影響範囲・追加の作業量・既存機能へのリスクを整理してから着手し、段階的に移行しました。
- 5
AIのコーディング支援ツール(Claude Codeなど)を、コードの生成・既存コードの調査・テストケース作成の補助に使いました。生成されたものはそのまま採用せず、仕様との整合性、セキュリティ、エラー処理、既存の設計への影響を確認し、必要な修正をしてから取り込んでいます。
Quality & Security
品質・セキュリティ・運用
テスト・レビュー
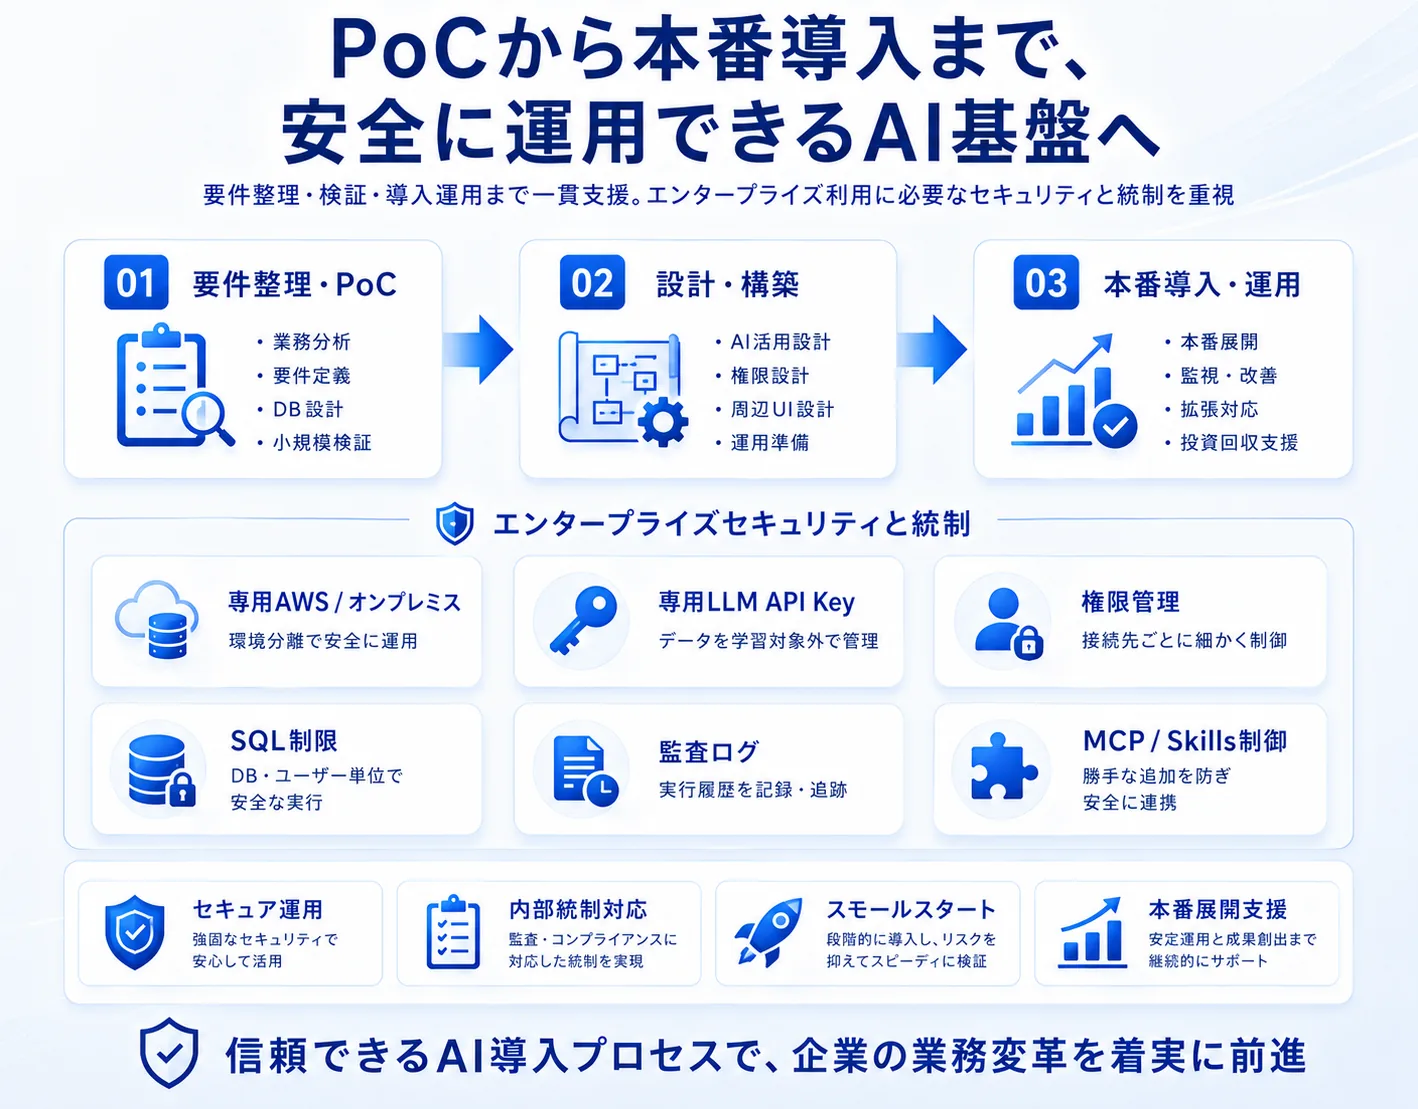
条件の判定など、中心となる処理にテストを整備しました。AWSに依存する部分はmotoで模擬しています。すべての統合の前に、コードレビューを必須にしました。
認証・セキュリティ
JWT認証、bcryptによるパスワードの保護、役割とデータベースごとの書き込み権限の制御、アクセス回数の制限を実装しました。機密情報は環境変数で管理し、Google連携はOAuthで認可を受けます。
AIの誤操作の防止
接続先のデータベースごとに書き込み権限を制御し、AIが勝手にデータを壊す操作をしないよう防いでいます。
人による確認
AIの出力やデータベースへの書き戻しの前に「データ確認」の工程を挟み、人が確認・修正してから確定します。AIの精度が100%であることを前提にせず、実務で使える設計にしました。
ログ・運用
日本時間で記録するログを、裏側の処理とAPIで一か所にまとめました。処理ごとに固有の番号を付けて追跡でき、ジョブの記録は毎日自動で整理します。
機密データの取り扱い
お客様の機密データや本番の実データを、外部のAIに入力しない運用を徹底しました。
Results
成果
これまでエンジニアへの依頼や手作業で行っていたデータの抽出・集計を、エンジニアではない担当者が自分で完結できるようになり、繰り返し発生する手作業がほぼ不要になりました。
- エンジニアではない担当者が、SQLやプログラムを書かずに、普段の言葉だけでデータベースの操作・分析を行えるようになりました。
- 複数の手順からなる定型のデータ業務を「タスク」として登録し、毎回同じ結果になる形で繰り返し実行できるようになりました。
- 分析結果の帳票やエクスポート(HTML・CSV・JSONなど)を自動で作れるようになり、手作業での集計や整形が減りました。
- Gmail・Googleカレンダー・Googleドライブとの連携まで含めて、一連の業務の流れをサービスの中で完結できるようになりました。
FAQ
技術面のよくあるご質問
- Q. AIの精度が低いときはどうなりますか?
- 「データ確認」の工程で、人が確認・修正してから確定します。AIの結果を、そのままデータベースに反映しない設計です。
- Q. AIの誤操作への対策は?
- データベースごとの読み書き権限の制御で、データを壊す操作を防いでいます。書き込む前には、データの形を検証します。
- Q. 機密情報はどう扱っていますか?
- 環境変数での管理、JWTとbcryptによる認証、OAuthによる認可に加えて、お客様の実データを外部のAIに入力しない運用をしています。
- Q. 仕様の大きな変更には、どう対応しましたか?
- 影響範囲、追加の作業量、既存機能へのリスクを整理してから着手し、既存機能を壊さないよう段階的に移行しました。
Tech Stack